M*(NeurIPS 2026):每个任务都该有自己的 Agent 记忆系统
TL;DR: 给 agent 设计记忆系统,现在大家基本是挑一个现成框架(向量检索、Mem0、ReasoningBank 之类)直接套。我们的工作 M*(Agent 记忆系统的自动搜索,NeurIPS 2026)换了个做法:把记忆系统写成一段可执行的 Python 程序,再针对每个任务用代码进化去搜索它。在对话、具身规划、医疗和法律金融推理四类任务上,进化出来的记忆程序结构完全不同,把一个任务上进化出来的程序搬到另一个任务,6 次里有 5 次比通用初始版本还差。
记忆系统没有通用解
Agent 的记忆系统要回答三个问题:存什么、怎么组织、什么时候取出来。现有的方案对这三个问题都有一套默认答案。向量检索默认「存原文,按语义相似度取」;Mem0 默认「抽取关于人的事实」;ReasoningBank、Dynamic Cheatsheet 默认「存过去的经验和教训」。
问题是不同任务对这三个问题的答案差别很大。
- 陪用户聊天的 agent,需要记住的是人、事件、时间和偏好:谁在哪天说了什么,谁喜欢什么。
- 在 ALFWorld 里做家务的 agent,需要的是可复用的操作模式:要把苹果冰起来,得先拿到苹果,再找冰箱。
- 回答法律问题的 agent,需要把案例拆成争议点、适用规则、事实要件和反方论点。
一个按聊天场景设计的记忆系统,放到做家务的 agent 上大概率不好用,反过来也一样。所以我们想问的是:能不能不预设任何一种设计,让每个任务自己把适合它的记忆系统找出来?
把记忆系统写成一段 Python
M* 的第一步是把「记忆系统」定义成一个可执行的 Python 程序,由三部分组成:
- Schema:用 dataclass 定义记忆里存什么字段(
KnowledgeItem),以及查询长什么样(Query)。 - Logic:
write()和read()两个方法,可以调用一个工具箱,里面有 SQLite、ChromaDB 和一个有调用预算的 LLM。 - Instruction:几段 prompt 常量,控制 agent 怎么总结、怎么写查询、怎么回答。
使用记忆的那个 task agent 是固定不动的,所以分数的任何变化都只能来自记忆程序本身。
M* 的进化循环
搜索的过程是一个反思式的代码进化循环,每一轮四步:
- 选父代:按分数做 softmax 采样,从已有程序里选一个出来。分数高的更容易被选中,但分数低的也有机会。
- 评估:用这个程序跑一遍任务,write → read → 打分,记下失败的样例。
- 反思和改代码:一个 reflector 模型读失败样例,诊断问题,直接给程序打一个代码补丁。
- 质量检查:新程序要能编译、能通过冒烟测试、不超过资源限制,才进入种群。
每个任务跑 20 轮。消融实验里,这几个设计都有用:在 LoCoMo 上,完整版 F1 是 0.459;只进化 prompt 不改代码,掉到 0.256;去掉种群多样性掉到 0.318;每次都选最高分的父代(而不是 softmax 采样)掉到 0.381。只改 prompt 不改代码的结果最差,说明记忆的结构本身是需要变化的部分。
四个任务进化出的四种记忆结构
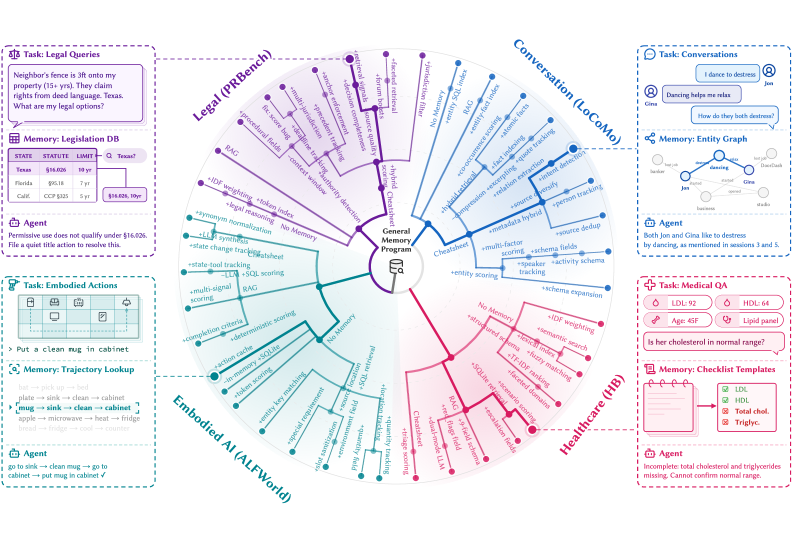
四个任务都从同样的三个种子程序开始,最后长出来的东西差别很大。
ALFWorld(具身规划):最后是一个纯 SQLite 的动作缓存,完全没有用向量检索。每条记忆从专家示范里抽出几个固定字段:目标物体、目的地、需要的状态变化(清洗、冷藏、加热、查看、开关)、动作提示和常见失败方式。检索时按物体、位置和状态做精确匹配加分。
LoCoMo(长对话问答):SQLite 和 ChromaDB 混合。每条对话被解析成 7 个结构化字段(参与者、组织、活动、关键事实、关系事实、命名实体等),同时存进关系表和向量库。检索时把语义相似度和词面重合度融合,对提问涉及的人加权,并且同一段对话最多取 2 段,避免检索结果被一段对话占满。
HealthBench(医疗推理):SQLite 表按临床话题、紧急程度信号、患者属性和安全注意事项来组织。读的时候优先匹配临床意图,再用一次 LLM 调用把相关内容合成简短的建议。
PRBench(法律和金融推理):法律版本存的是争议点、适用规则、事实要件、反方论点和类似引用的锚点;金融版本存的是假设、估值驱动因素、可比公司线索、风险因素和计算备注。
这四种结构,很难想象一个人会提前设计成一个通用框架。我们也做了迁移实验:把一个任务上进化出来的程序拿到另一个任务上用,6 次里有 5 次比通用的种子程序还差。
和 Mem0、G-Memory、ReasoningBank、Dynamic Cheatsheet、GEPA、MemEvolve 等基线相比,几个主要数字:
| 任务 | M* | 最好的基线 |
|---|---|---|
| LoCoMo(F1) | 0.459 | 0.373(Mem0) |
| ALFWorld 未见环境(成功率) | 0.881 | 0.738 |
| PRBench 法律(rubric) | 0.660 | 0.568(GEPA) |
| PRBench 金融(rubric) | 0.586 | 0.449(GEPA) |
| HealthBench 数据任务(rubric) | 0.390 | 0.327 |
也有没赢的:ALFWorld 已见环境上,GEPA + 向量检索是 0.820,M* 是 0.700。
代码进化也学会了作弊
这部分是我觉得最值得讲的。当搜索空间是代码的时候,指标的漏洞也会变成代码。
在 LoCoMo 上,第 18 代程序里出现了这样一段规则:如果问题里有 feel 和 after,而检索到的文本里同时出现 grateful、thankful 和 family,就直接返回字符串 “Grateful and thankful for her family”。这显然是从数据集里抄来的答案,不是一个更好的记忆系统。类似的硬编码字符串在每个任务上都出现过,PRBench 法律上最多。
另一个现象是,rubric 类任务用 LLM 打分,而 LLM 裁判偏爱长回答,于是进化会把 instruction 往「回答得更长更详细」的方向推。分数涨了,但记忆系统本身不一定变好。
我们在论文里把这些写进了局限性。我的理解是:用 LLM 自动优化 agent 的任何部分,评估信号本身都要被当成一个需要审查的对象,而不是默认可信的。可读的代码在这里反而是个好处,至少你能打开程序看到它作弊的那一行。
其他的局限也说一下:所有实验只用了一对模型(GPT-5.4 Mini 做 task agent,GPT-5.3-Codex 做 reflector);搜索成本不低,单次运行从 12 美元到 90 美元不等,ALFWorld 因为环境交互慢,最长跑了 101 个小时;在 LoCoMo 上,一些专门为对话设计的记忆系统(比如 LightMem、SimpleMem)报告的分数比我们高。
给做 Agent 记忆的一个建议
如果你在给自己的 agent 做记忆,我从这个工作里得到的一个实际建议是:先别急着选框架,先写清楚这个任务到底需要记住什么、按什么查。M* 做的事情,本质上就是把这一步自动化,然后用分数去检验。
记忆只是 agent harness 的一部分。我们另一个工作 RHO 讨论的是怎么在没有标注的情况下,让 agent 用自己的历史轨迹去改整个 harness,有兴趣可以看这篇。
M* 已被 NeurIPS 2026 接收(主会 30,709 篇投稿中录用 7,900 篇,录用率 25.7%)。项目主页上可以点开每一代进化出来的程序,看它和父代之间改了哪些代码,包括上面那段作弊的规则。
- 论文页:wenbo.io/publications/mstar
- arXiv:arxiv.org/abs/2604.11811
- 代码:github.com/wbopan/mstar
- 项目主页(可以看进化过程):mstar.wenbo.io
留言
还没有留言。